As instruções da voz gravada do GPS nunca dizem o nome da rua, e existe um motivo técnico simples pra isso
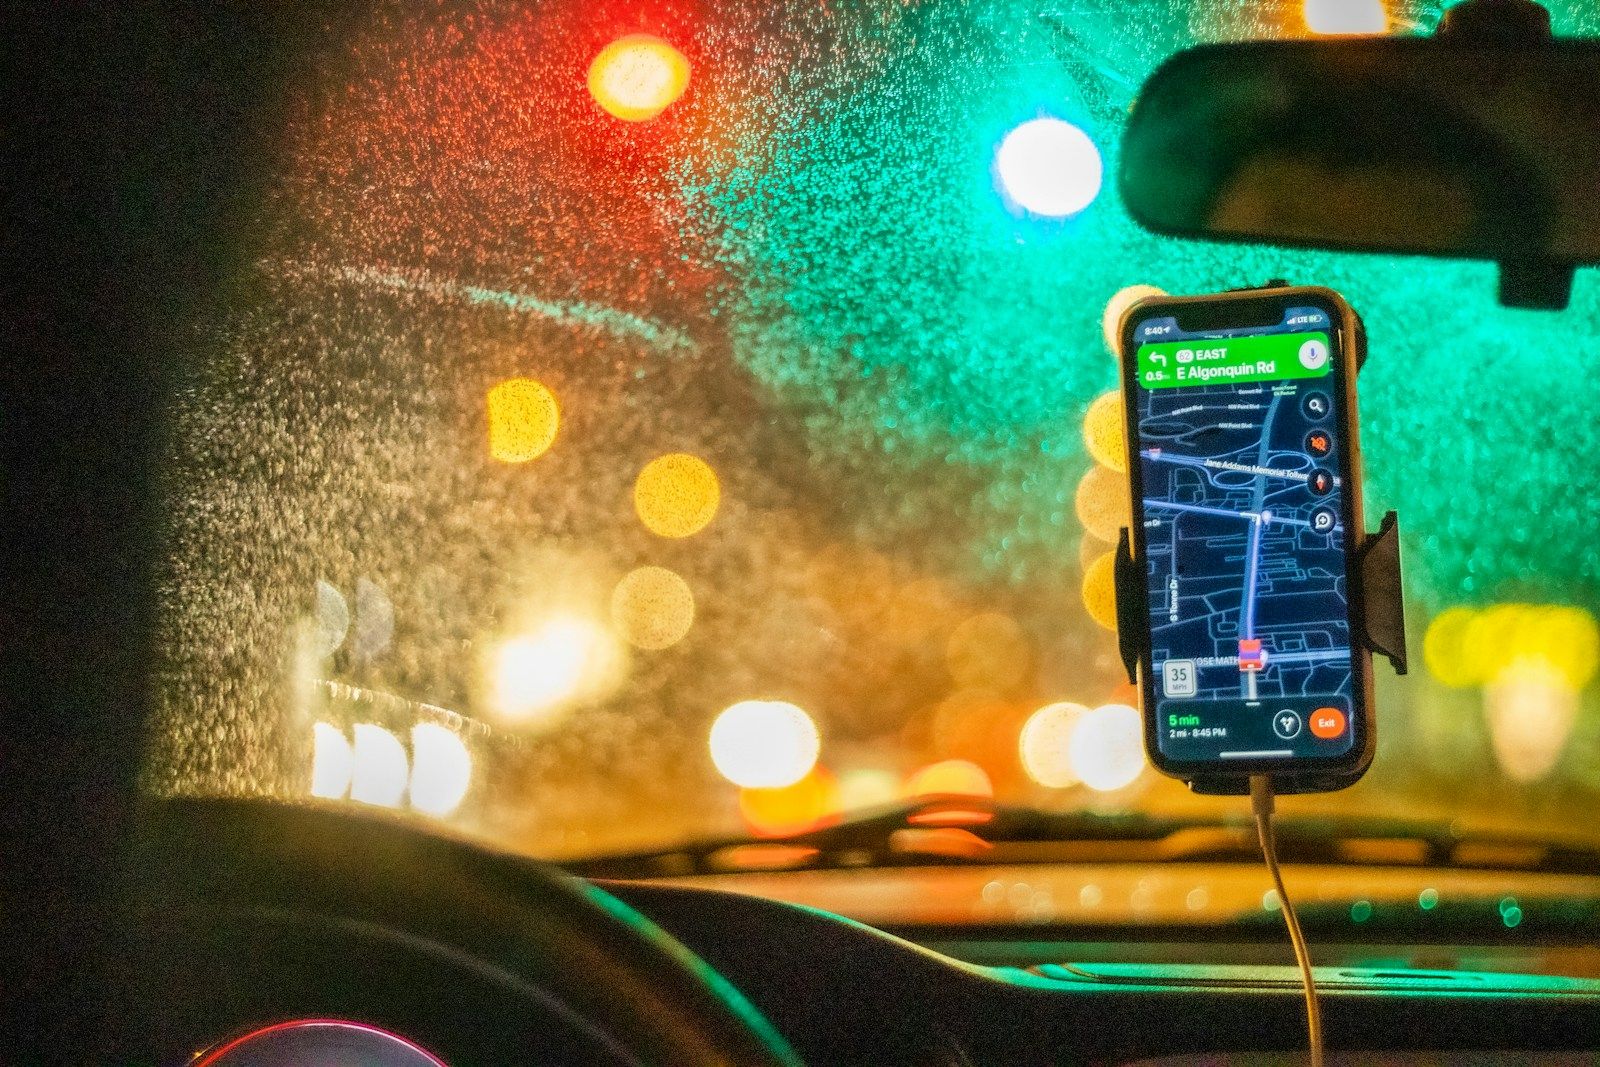
A voz do Waze e do GPS nunca fala o nome da sua rua, e existe um motivo técnico simples pra isso. Entenda a diferença entre voz gravada e voz sintética, e por que isso ainda é trabalho de locutor.
Toda vez que um aplicativo de navegação avisa "em duzentos metros, vire à direita", ele nunca diz o nome da rua pra onde você está virando. Existe um motivo técnico simples pra isso, ligado a como boa parte dessas vozes é feita, e é exatamente esse limite técnico que garante trabalho pra locutor, mesmo com Siri, Alexa e Google Assistente cada vez mais presentes.
Dois tipos de voz, dois processos completamente diferentes
Sistemas de navegação como Waze e TomTom oferecem dois tipos de voz. O primeiro é a voz gravada: um locutor grava, em estúdio, um banco fixo de frases prontas, vire à direita, siga em frente, você chegou ao destino, recalculando rota, e o aplicativo só combina esses trechos gravados durante o trajeto. É por isso que essa voz nunca fala o nome da rua: não daria pra gravar previamente cada uma das milhões de ruas que existem no mapa. O segundo tipo é a voz artificial, gerada por texto pra fala, que lê qualquer coisa em tempo real, incluindo nome de rua, mensagem recebida ou previsão do tempo, mas em troca soa mais sintética.
No Brasil, o Waze traz como padrão duas vozes, batizadas de Alessandra e Mario, além de vender vozes de celebridade como atrativo: já teve MC Fioti, Pabllo Vittar e Xanddy no catálogo, ao lado de personagens de jogo e cinema. Todas elas seguem a mesma regra da voz gravada: dizem instrução, não dizem endereço.
Um banco de frases é, ainda assim, trabalho de locutor
Gravar um pacote de voz de navegação significa decorar e repetir a mesma dezena de frases em variações e intensidades diferentes, sustentando um tom neutro e claro que precisa funcionar tanto pra um motorista tranquilo na cidade quanto pra alguém perdido debaixo de chuva, sem perder a compreensão em nenhum dos dois casos. É um trabalho de estúdio, com direção, várias tomadas da mesma frase, e o cuidado de nunca soar cansado na centésima repetição de "siga em frente". A tecnologia decide quando cada trecho toca, mas quem grava o trecho ainda é gente, porque nenhuma voz sintética convence tanto quanto uma voz humana bem dirigida em cima de instrução simples e recorrente.
Essa combinação de dicção limpa e tom neutro sustentado por muitas tomadas é o tipo de base técnica que se treina desde o início, no curso de Locução Básica da Escola de Rádio.
Posts relacionados
Trinta e nove de 42 funcionários de uma rádio carioca foram demitidos quando um software passou a tocar a madrugada inteira sozinho
Décadas antes da IA generativa, softwares de automação de playlist já substituíam locutores de madrugada no rádio brasileiro. O caso documentado da Rádio Paradiso FM e o que sobrou de mercado pra quem construiu identidade sonora própria.
O Brasil trocou a sirene de alerta de desastre por um som que atravessa até o modo silencioso do celular
Desde outubro de 2025, o sistema Defesa Civil Alerta manda mensagem de emergência pra todo celular numa área de risco, sem cadastro. Como funciona a tecnologia de cell broadcast, o caso real das enchentes do RS, e o risco de um alerta falso.
4 mil chamados de emergência atendidos por uma única casa em Porto Alegre, um ano antes de virar rede oficial
Nas enchentes do RS em 2024, um radioamador voluntário atendeu mais de 4 mil chamados de emergência numa estação improvisada em casa. Só um ano depois isso virou rede oficial de Anatel, LABRE e Defesa Civil. Por que o rádio ainda funciona quando tudo o mais cai.